

Desde el lanzamiento de ChatGPT en noviembre de 2022, la Inteligencia Artificial Generativa ha capturado la atención del mundo, y con razón. Su potencial para transformar los procesos empresariales es innegable. Sin embargo, a pesar del entusiasmo, muchos líderes aún se muestran cautelosos, preocupados por los riesgos, la complejidad y los costes asociados a su implementación, lo que a menudo eclipsa las enormes posibilidades que ofrecen.
Entre los principales desafíos que presenta la IA a través de los LLM (Grandes Modelos de Lenguaje), destacan las "alucinaciones" y el conocimiento desactualizado. Las alucinaciones afirmaciones incorrectas que se exponen como verdades correctas, como cuando un LLM afirma que "La Estatua de la Libertad se encuentra en Toronto desde 1915" (un dato que, como bien sabemos, es incorrecto, ya que se inauguró en Nueva York en 1886... o ¿era 1884? Bueno, en cualquier caso, ¡no en Toronto!), ilustran la capacidad de estos modelos para generar afirmaciones gramaticalmente correctas pero factualmente incorrectas.
Otro riesgo importante es el conocimiento desactualizado, también conocido como "fecha de corte" o "knowledge cutoff". Los LLM se entrenan con un extenso corpus de texto hasta una fecha determinada, lo que significa que pueden tener dificultades para proporcionar información precisa sobre eventos posteriores a esa fecha. Por ejemplo, un LLM podría responder: "Lo siento, no tengo información sobre eventos ocurridos después de septiembre de 2023".
Estos desafíos plantean preguntas cruciales: ¿Cómo podemos garantizar la fiabilidad de la información proporcionada por un asistente de IA? ¿Es necesario reentrenar constantemente el modelo para mantenerlo actualizado?
Diferenciador
En respuesta a estos desafíos, emerge una técnica innovadora que está revolucionando la forma en que los LLM acceden y utilizan la información: la Recuperación Aumentada Generativa (RAG). Los RAG permiten a los LLM superar sus limitaciones al acceder a fuentes de información externas y actualizadas, proporcionando respuestas más precisas, contextualizadas y fiables.
El objetivo de un RAG es combinar la capacidad de generación de texto propia de los modelos de lenguaje con la recuperación de información externa. En términos más sencillos, un RAG nutre el prompt del usuario con datos relevantes extraídos de una base de conocimiento propia antes de generar la respuesta. De esta manera, el modelo puede fundamentar sus respuestas en información específica y actualizada obtenida de fuentes autorizadas, en lugar de basarse únicamente en lo que "recuerda" de su entrenamiento, lo que disminuye los riesgos de alucinaciones y el conocimiento desactualizado.
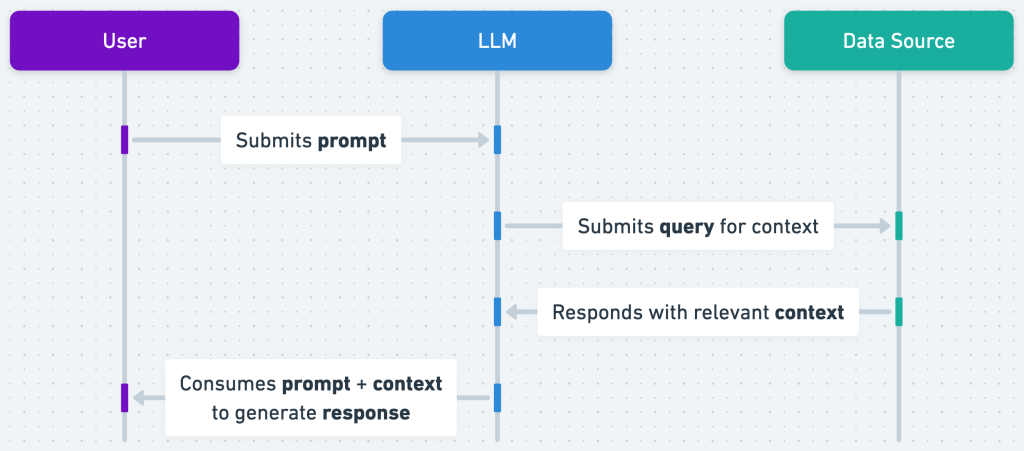
En la práctica, un sistema RAG típicamente incluye un LLM, junto con un componente de búsqueda o recuperación (por ejemplo, un buscador semántico o una base de datos interna) que suministra los datos necesarios para responder con precisión. Antes de generar la respuesta, RAG busca en los documentos relevantes y aporta ese contexto al modelo, asegurando así que la salida haga referencia a información verídica y contextualizada.
En Mottum Analytica, hemos trabajado con la tecnología RAG para ofrecer una alternativa que permite a las empresas mantener sus datos bajo control en entornos privados y seguros. Nuestras soluciones permiten la implementación en los propios servidores de la empresa o en una nube segura y privada, y se ofrecen a través de diversos canales de consumo, como la web o WhatsApp, adaptándonos a las necesidades de cada cliente.
¿Cuándo se recomienda usar RAG?
Implementar una solución con RAG requiere la integración de diversas piezas tecnológicas complejas: un LLM, un motor de búsqueda semántica, una base de datos de documentos robusta y una lógica de orquestación sofisticada que permita la interacción fluida entre estos componentes. La correcta configuración y mantenimiento de este ecosistema tecnológico presenta desafíos significativos en términos de desarrollo, escalabilidad y rendimiento. Todo esto se complica aún más si no se cuenta con la experiencia previa necesaria en el desarrollo e implementación de este tipo de sistemas.
Otro desafío importante radica en el manejo adecuado de la información sensible. El uso directo de LLM como ChatGPT implica, en muchos casos, enviar las consultas y potencialmente datos confidenciales de la empresa a servidores externos, como los de OpenAI o, como en el reciente caso de DeepSeek, a servidores ubicados en China. Esta práctica puede contravenir políticas internas de seguridad de la información o regulaciones externas (como las relativas a la protección de datos personales, información confidencial de clientes, secretos industriales, etc.). Es crucial considerar las implicaciones legales y de seguridad antes de implementar cualquier solución que involucre el procesamiento de datos sensibles por parte de terceros.
Riesgos
Implementar una solución con RAG requiere la integración de diversas piezas tecnológicas complejas: un LLM, un motor de búsqueda semántica o vectorial eficiente, una base de datos de documentos robusta y una lógica de orquestación sofisticada que permita la interacción fluida entre estos componentes. La correcta configuración y mantenimiento de este ecosistema tecnológico presenta desafíos significativos en términos de desarrollo, escalabilidad y rendimiento. Todo esto se complica aún más si no se cuenta con la experiencia previa necesaria en el desarrollo e implementación de este tipo de sistemas.
Otro desafío importante radica en el manejo adecuado de la información sensible. El uso directo de LLM como ChatGPT implica, en muchos casos, enviar las consultas y potencialmente datos confidenciales de la empresa a servidores externos, como los de OpenAI o, como en el reciente caso de DeepSeek, a servidores ubicados en China. Esta práctica puede contravenir políticas internas de seguridad de la información o regulaciones externas (como las relativas a la protección de datos personales, información confidencial de clientes, secretos industriales, etc.). Es crucial considerar las implicaciones legales y de seguridad antes de implementar cualquier solución que involucra el procesamiento de datos sensibles por parte de terceros.
Conclusión
LLM y RAG representan dos caras complementarias de la revolución de la IA en el ámbito empresarial. Los LLM, con su sorprendente capacidad para generar lenguaje natural, han abierto los ojos al mundo sobre el potencial de la IA en tareas de comunicación y creación de contenido. La técnica de RAG, por su parte, surge como una respuesta efectiva a la necesidad de acceder a información actualizada y precisa, construyendo un puente esencial entre el vasto conocimiento general que posee un modelo y los datos específicos y contextuales que una organización maneja.
Es de esperar que las soluciones de IA más robustas y eficientes combinan ambos enfoques de manera sinérgica. En Mottum creamos asistentes inteligentes capaces de mantener un diálogo natural y abierto (al estilo de ChatGPT), pero que, en segundo plano, consultan bases de datos, informes, la web y otras fuentes de información relevantes para fundamentar cada respuesta con precisión y contexto. Esta combinación permite crear sistemas de IA más fiables, informativos y adaptados a las necesidades específicas de cada organización.
Escríbenos si necesitas implementar una solución basada en RAG para “hablar” con tu información de manera segura o incluso si quieres entender más cómo funciona y de qué manera te podría simplificar la gestión de datos.